Capitolo 10 di 12
Omni reference
L'omni reference è la tecnica che ha cambiato il modo di fare film con l'AI: invece di partire da un solo testo o da una sola immagine, si danno al modello tutti gli ingredienti della scena insieme.
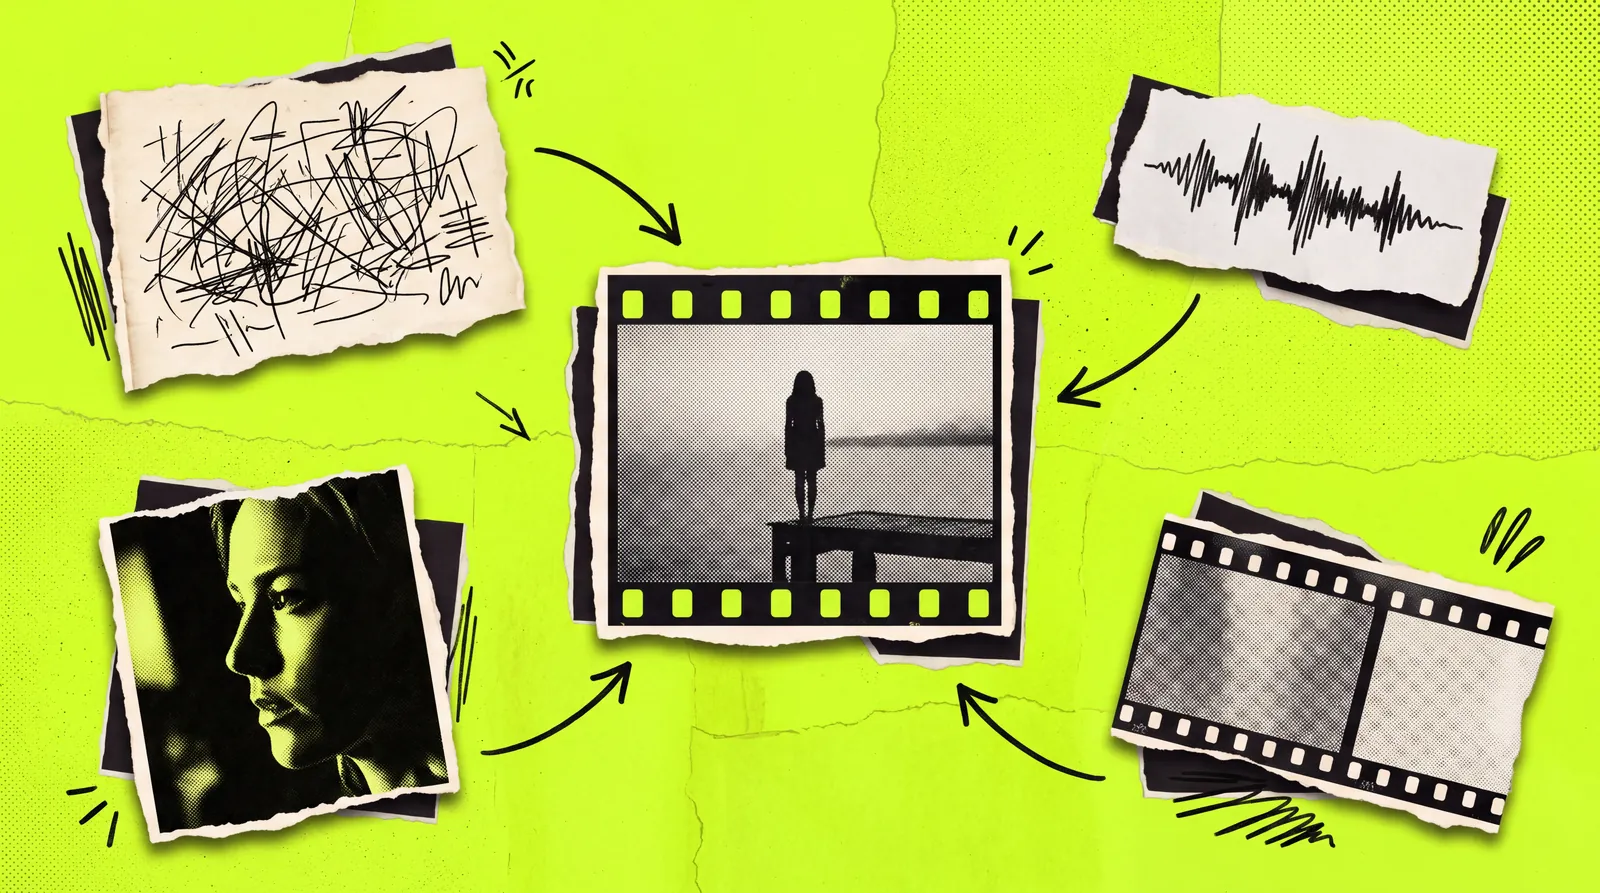
Con l'omni reference il modello video riceve insieme più riferimenti di tipo diverso: il testo del prompt, le immagini dei personaggi, dei luoghi e degli oggetti, uno o più video e uno o più audio. Li combina in un'unica generazione, usando ciascuno per lo scopo che gli indichi.
È un salto rispetto al semplice video da immagine: invece di animare un fotogramma, il modello costruisce la scena a partire da tutti gli elementi che hai preparato nelle fasi precedenti. Character sheet, schede dei luoghi, oggetti di scena, voci, movimenti di riferimento e clip precedenti diventano gli ingredienti della stessa inquadratura.
Ogni tipo di riferimento porta al modello informazioni diverse, ed è importante sapere cosa aspettarsi da ciascuno.
Il testo è l'unico riferimento sempre presente e fa da regista: senza un prompt che spieghi cosa fare con ogni file, il modello deve indovinare.
Seedance 2.5 è a ottobre 2026 il modello con la gestione dei riferimenti più ampia: in una sola generazione accetta fino a 30 immagini, 10 clip video e 10 clip audio. Supporta anche riferimenti particolari, come modelli 3D senza texture per impostare disposizione, pose e camera, riferimenti di movimento e riferimenti creativi.
Mantiene l'aspetto e la voce di più personaggi nella stessa scena e la continuità di personaggi e ambienti quando la clip viene estesa. Questo lo rende particolarmente adatto alle scene di dialogo e alle sequenze con più personaggi, purché ogni riferimento sia chiaramente assegnato nel prompt.
Kling 4 accetta fino a 15 riferimenti tra immagini, video e audio, pensati soprattutto per mantenere coerenti i personaggi tra inquadrature ed episodi. In più permette di fissare fino a 10 fotogrammi chiave lungo la clip, per controllare con precisione come evolve la scena: dove si trovano i personaggi in un certo momento, quando avviene un cambio di inquadratura, come procede la storia.
I video di riferimento possono guidare la recitazione, l'azione, il movimento di camera e il ritmo, anche quando sono grezzi, come un modello 3D senza texture o una mappa di profondità. Il prompt può arrivare a descrizioni molto lunghe, utili per i brief creativi dettagliati preparati con un assistente AI.
Un video di riferimento può dire al modello cose che nessuna descrizione riesce a esprimere: il modo esatto in cui un personaggio si muove, il ritmo di un'azione, il percorso preciso della camera. Può essere una clip generata in precedenza, una ripresa girata con il telefono in cui reciti tu stesso l'azione, o una ripresa grezza di un set 3D.
È anche lo strumento alla base della concatenazione: la clip precedente usata come riferimento porta con sé luce, location e recitazione. Nel prompt specifica sempre cosa deve prendere il modello da quel video: solo il movimento di camera, solo la recitazione, oppure la continuità completa della scena.
I modelli che generano audio e video insieme accettano anche riferimenti sonori. Un breve campione della voce di un personaggio, creata per esempio con ElevenLabs, permette al modello di farlo parlare sempre con la stessa voce. Un brano musicale può dare il ritmo al montaggio interno di un multi shot, e un suono d'ambiente può guidare l'atmosfera.
L'audio è anche il modo per controllare con precisione i dialoghi: puoi generare le battute separatamente, con l'intonazione e le pause che vuoi, e usarle come riferimento perché il modello sincronizzi le labbra dei personaggi. Ne parliamo nel dettaglio nel capitolo successivo.
La regola d'oro dell'omni reference è assegnare a ogni riferimento un ruolo preciso, una sola volta, nel punto del prompt in cui serve. Per esempio: la donna di @Image 1 è la protagonista, il porto di @Image 2 è la location, la lettera di @Image 3 è l'oggetto che riceve, @Video 1 è la clip da continuare, @Audio 1 è la sua voce.
I tag seguono l'ordine di caricamento e sono consecutivi per ciascun tipo di file. Se un riferimento non serve in quella generazione, non va caricato: un file presente ma non spiegato confonde il modello, che proverà comunque a usarlo in qualche modo.
Più riferimenti non significa risultati migliori. Oltre un certo numero, il modello fatica a capire quale informazione prendere da quale file, e il risultato peggiora: volti che si mescolano, oggetti che compaiono dove non dovrebbero, stili che si sovrappongono.
Per ogni generazione carica solo ciò che serve davvero a quell'inquadratura: i personaggi presenti, il luogo, gli oggetti che compaiono e, se serve, la clip precedente e la voce di chi parla. Tutto il resto resta nella scheda di produzione, pronto per le inquadrature in cui servirà.
Mettiamo insieme tutto con la scena del nostro esempio. La clip qui accanto nasce da due riferimenti: il character sheet della donna come @Image 1 e quello del pescatore come @Image 2. Nel prompt, prima i ruoli, poi le due inquadrature con i tempi, infine luce e stile. In un progetto completo aggiungeresti la scheda del porto come @Image 3 e la clip precedente come @Video 1.
Il risultato è una clip con gli stessi personaggi, nello stesso luogo, con la stessa luce, e in cui succede esattamente ciò che avevamo scritto nella lista delle inquadrature. È il punto d'arrivo di tutto il lavoro fatto nei capitoli precedenti: sceneggiatura, prompt, character sheet, world building e concatenazione.
Audio nativo o separato, le voci con ElevenLabs, il lip sync, la musica con Suno, Udio e Flow Music e le licenze.